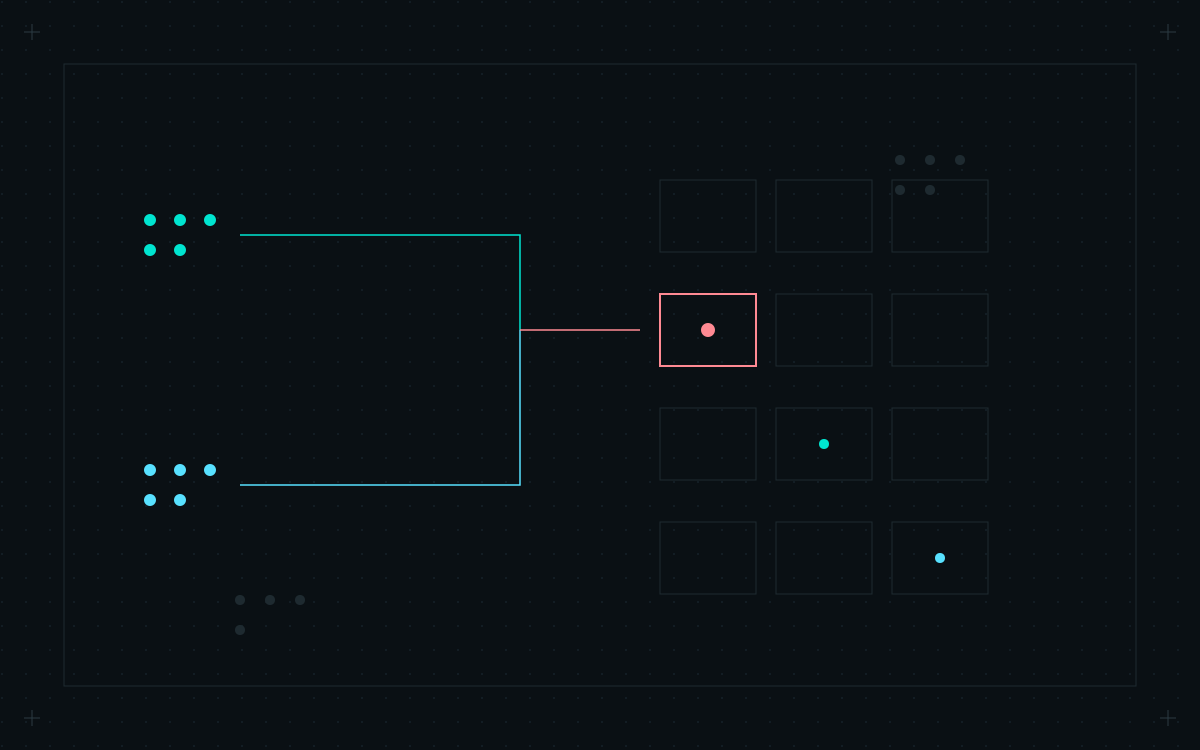
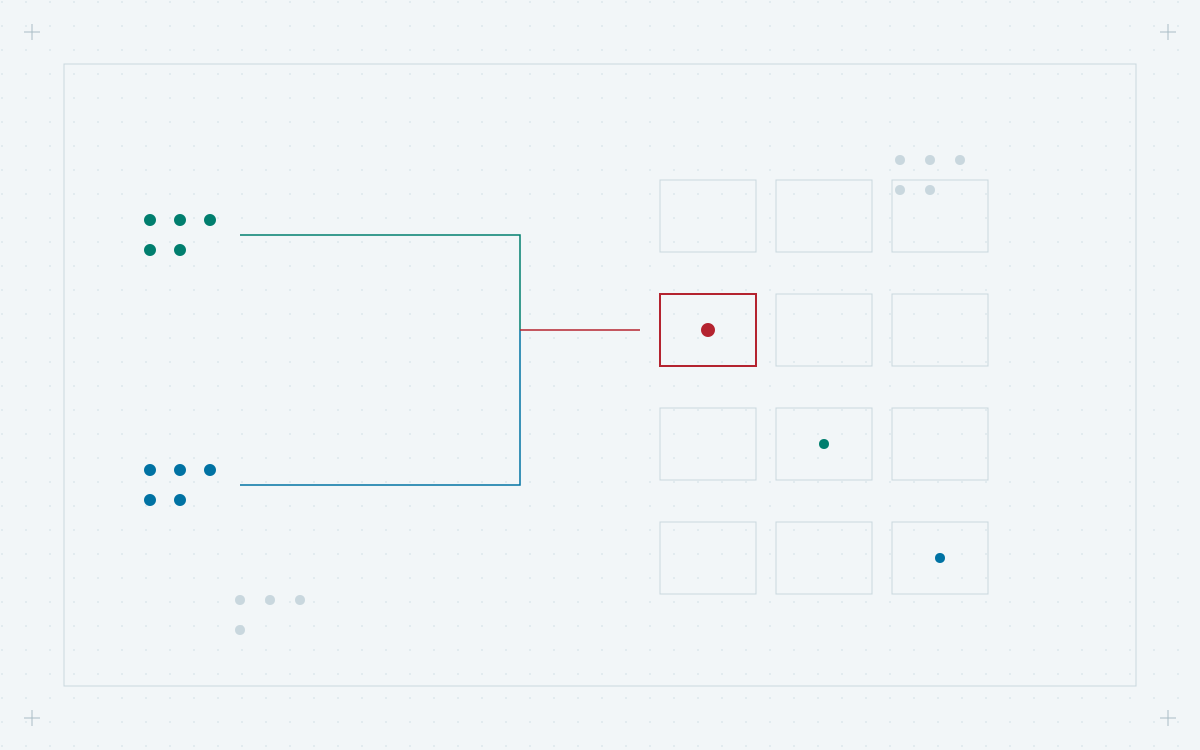
El 26 de octubre Cloudflare publicó el post-mortem de un incidente de aislamiento en Workers AI: entre el 27 de agosto y el 9 de septiembre, el modelo GLM-5.3 devolvió respuestas que incluían datos de requests de otros clientes. Fueron 155 respuestas afectadas, todas a prompts de más de 681.280 tokens. No era una caché de respuestas ni una clave sin tenant: era memoria KV del modelo que el proceso de decode leyó sin haberla sobrescrito.
Qué pasó, sin adornos
Ventana: 27 de agosto a 9 de septiembre de 2026.
Alcance: 155 respuestas con datos de requests anteriores de otros clientes; Cloudflare no encontró evidencia de explotación deliberada.
Causa: el pool KV de prefill admitía 681.280 tokens frente a una ventana anunciada de 1.048.576; un bug de SGLang permitía que un request rechazado siguiera hasta decode.
Disclosure: post-mortem público el 26 de octubre, con línea de tiempo y corrección.
La página que decode nunca debió leer
Prefill no es decode
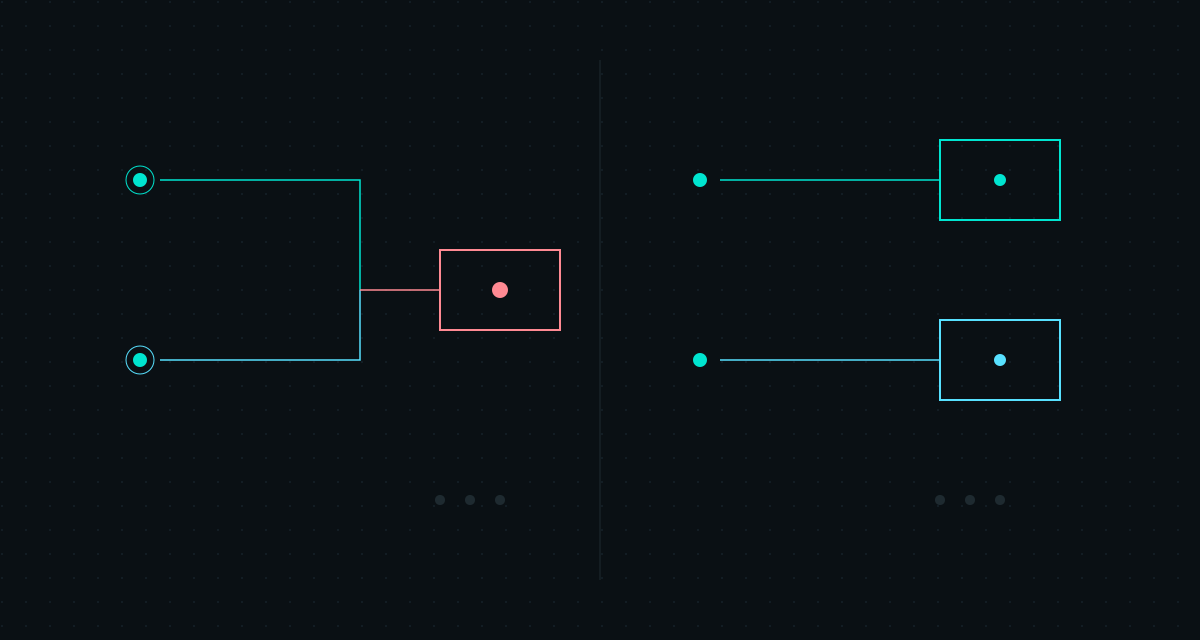
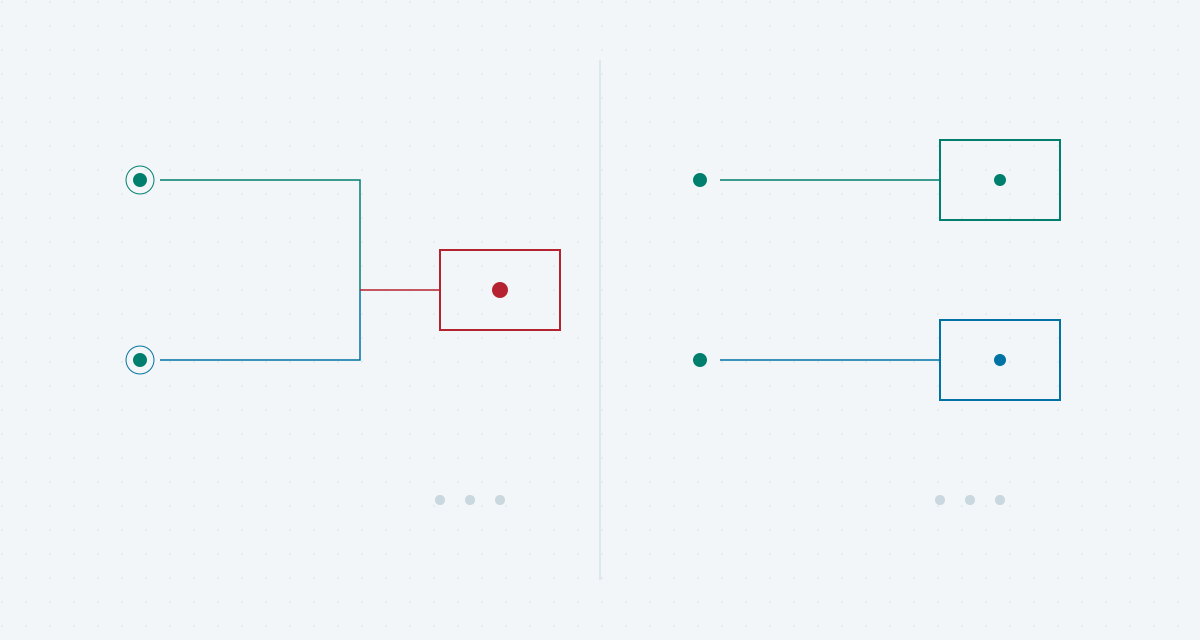
SGLang separa prefill (procesar el prompt) de decode (generar la respuesta). Cuando un prompt no cabía en el pool, prefill lo marcaba como rechazado y procesaba un placeholder de un token. Sin embargo, decode reservaba páginas para el prompt completo y recibía la señal de transferencia completada. Solo una página contenía datos nuevos; las demás conservaban información de otros requests. Decode generaba sobre esas páginas antiguas y respondía HTTP 200 en vez de devolver un error.
// Ejemplo ilustrativo: valida la capacidad real del pool.
function assertCapacity(contextLimit: number, kvPoolTokens: number) {
  if (kvPoolTokens < contextLimit) {
    throw new Error('KV pool menor que la ventana de contexto')
  }
}

// Y en el handoff: nunca decodifiques un rechazo.
if (prefill.rejected || transferredTokens !== reservedTokens) {
  throw new Error('handoff KV incompleto')
}
Lo que me llevo a mis propios sistemas
Medir la capacidad efectiva del pool KV contra la ventana de contexto en cada despliegue; no asumir que el HTTP 200 prueba coherencia.
Probar el camino de rechazo con prompts que excedan el pool y verificar el contenido de la respuesta, no solo el status.
Rechazar requests abortados antes de reservar o transferir páginas; comprobar que los tokens transferidos igualan los reservados.
Actualizar SGLang a v0.5.22 o posterior en despliegues disaggregated y habilitar las comprobaciones de integridad disponibles.
Un request rechazado no puede seguir vivo en la otra mitad de un sistema distribuido.
Fuente primaria: el post-mortem de Cloudflare(Se abre en una pestaña nueva) y la publicación coordinada del equipo de SGLang(Se abre en una pestaña nueva).